وقتی با MongoDB کار میکنیم، خیلی از Queryها در ابتدا ساده هستند. مثلا میخوایم یه document رو براساس وضعیتش پیدا کنیم، چندتا شرط بذاریم یا خروجی رو sort کنیم.
ولی وقتی وارد فرآیندهای واقعی اپلیکیشن میشیم، ماجرا یه مقدار فرق میکنه.
مثلا میخوایم درخواستهای ۱۰ روز اخیر رو پیدا کنیم، اطلاعات کاربری که درخواست رو ثبت کرده از یه collection دیگه بگیریم، بررسی کنیم بالای ۱۸ سال هست یا نه، ببینیم فایلی آپلود کرده یا نه و در نهایت هم تعداد درخواستها و یه summary از وضعیتشون داشته باشیم.
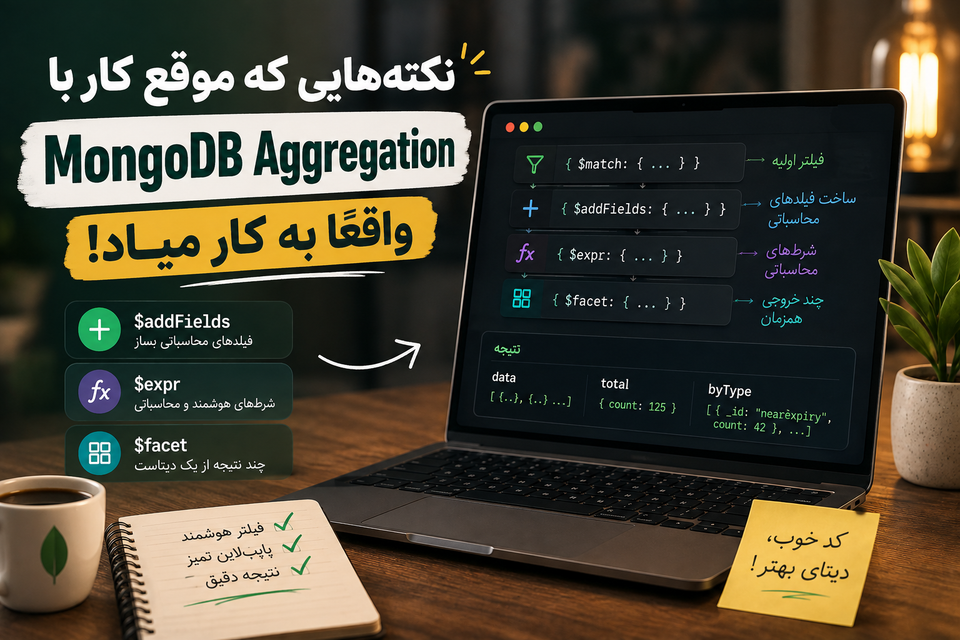
اینجاست که با چیزهایی مثل $addFields، $expr، $lookup، $switch و $facet بیشتر سروکار داریم.
توی این پست یه سری نکته از کار با MongoDB و Mongoose رو مینویسم. از Queryهای ساده شروع میکنیم و کمکم به Aggregationهایی میرسیم که توی پروژههای واقعی بیشتر به دردمون میخورن.
Queryهای ساده و شرطهای مختلف
برای پیدا کردن اطلاعات از find استفاده میکنیم.
مثلا اگر یه collection از کاربران داشته باشیم:
db.users.find({
  city: "Tehran"
})
یا مثلا کاربرانی که سنشون بیشتر از ۱۸ هست:
db.users.find({
  age: {
    $gte: 18
  }
})
یه سری operator داریم که تقریبا همهجا استفاده میشن:
$eqبرای برابر بودن$neبرای نابرابر بودن$gtو$gteبرای بزرگتر بودن$ltو$lteبرای کوچکتر بودن$inبرای بررسی اینکه یه مقدار داخل چند مقدار مشخص هست یا نه$ninبرای برعکس حالت قبلی
مثلا اگر بخوایم درخواستهایی رو بگیریم که وضعیتشون pending یا approved هست:
db.requests.find({
  status: {
    $in: ["pending", "approved"]
  }
})
این Query رو میتونیم با $or هم بنویسیم:
db.requests.find({
  $or: [
    { status: "pending" },
    { status: "approved" }
  ]
})
ولی وقتی روی یه فیلد چند مقدار رو بررسی میکنیم، معمولا $in خواناتر هست.
اگر چندتا شرط رو هم کنار هم قرار بدیم، بهصورت پیشفرض با AND بررسی میشن:
db.requests.find({
  status: "approved",
  isCanceled: false,
  permitType: 3
})
یعنی هر سه شرط باید برقرار باشند.
کوئری روی فیلدهای داخلی و آرایهها
فرض کنیم یه document داریم که اطلاعات کاربر داخل profile نگهداری میشه:
{
  name: "User A",
  profile: {
    city: "Tehran",
    age: 25
  }
}
برای دسترسی به فیلدهای داخلی از Dot Notation استفاده میکنیم:
db.users.find({
  "profile.city": "Tehran"
})
همین روش برای آرایههایی از object هم استفاده میشه.
مثلا:
{
  processPermission: [
    { status: 1 },
    { status: 2 },
    { status: 0 }
  ]
}
اگر بخوایم documentهایی رو پیدا کنیم که حداقل یکی از اعضای processPermission وضعیت ۱ داره:
db.requests.find({
  "processPermission.status": 1
})
ولی اگر دقیقا عضو دوم آرایه مدنظر باشه:
db.requests.find({
  "processPermission.1.status": 1
})
چون index آرایه از صفر شروع میشه، 1 یعنی عضو دوم.
این دو تا Query کاملا متفاوت هستند. اولی وجود وضعیت ۱ در هر عضو آرایه رو بررسی میکنه، ولی دومی فقط عضو دوم رو.
استفاده از $elemMatch
یه نکتهی دیگه وقتی هست که چند شرط روی یک عضو مشخص از آرایه داریم.
مثلا:
db.orders.find({
  items: {
    $elemMatch: {
      quantity: { $gt: 2 },
      price: { $gte: 100 }
    }
  }
})
اینجا MongoDB بررسی میکنه که حداقل یک item وجود داشته باشه که هم تعدادش بیشتر از ۲ باشه و هم قیمتش حداقل ۱۰۰.
بدون $elemMatch ممکنه یکی از شرطها روی یه عضو و شرط دیگه روی عضو متفاوتی از آرایه برقرار باشه.
ارتباط بین Collectionها؛ ref و populate
وقتی با Mongoose کار میکنیم، برای ارتباط بین مدلها معمولا از ObjectId و ref استفاده میکنیم.
مثلا فرض کنیم هر Request توسط یه User ثبت شده:
const requestSchema = new Schema({
  requestBy: {
    type: Schema.Types.ObjectId,
    ref: 'User',
  },

  status: String,
  createdAt: Date,
});
اینجا requestBy یه ObjectId هست که به مدل User اشاره میکنه.
برای گرفتن اطلاعات User:
const requests = await Request.find()
  .populate('requestBy', 'name email');
Mongoose مقدار ObjectId رو با document مربوط به User جایگزین میکنه.
فقط باید حواسمون باشه که populate قرار نیست همهی کارهایی که با Join داخل دیتابیس انجام میدیم رو پوشش بده.
مثلا اگر بخوایم Requestها رو براساس یه فیلد از User فیلتر کنیم، استفاده از populate({ match: ... }) لزوما Requestهای نامرتبط رو از خروجی حذف نمیکنه.
برای این مدل Queryها معمولا $lookup انتخاب مناسبتریه.
Aggregation Pipeline
به نظرم راحتترین روش برای فهمیدن Aggregation اینه که هر Stage رو به چشم یه مرحله از پردازش اطلاعات ببینیم.
مثلا:
Requests
    ↓
$match
    ↓
$lookup
    ↓
$unwind
    ↓
$addFields
    ↓
$match
    ↓
$facet
هر Stage اطلاعاتی که از مرحله قبل دریافت کرده رو پردازش میکنه و به مرحله بعد میفرسته.
مثلا:
const pipeline = [
  {
    $match: {
      status: 'approved',
    },
  },

  {
    $sort: {
      createdAt: -1,
    },
  },

  {
    $limit: 10,
  },
];
اول Requestهای approved رو پیدا میکنه، بعد از جدید به قدیم مرتب میکنه و در نهایت ۱۰ مورد رو نگه میداره.
ولی وقتی میخوایم اطلاعات جدید محاسبه کنیم یا با collectionهای دیگه کار کنیم، Pipeline جذابتر میشه.
$lookup و $unwind
فرض کنیم اطلاعات Request رو داریم، ولی باید اطلاعات کسی که درخواست رو ثبت کرده هم داخل خروجی باشه.
{
  $lookup: {
    from: 'users',
    localField: 'requestBy',
    foreignField: '_id',
    as: 'requester',
  },
}
این Stage مقدار requestBy رو با _id داخل collection کاربران مقایسه میکنه.
نکته اینه که خروجی $lookup همیشه آرایه هست، حتی اگر فقط یه User پیدا بشه.
پس معمولا بعدش از $unwind استفاده میکنیم:
{
  $unwind: '$requester',
}
حالا بهجای یه آرایه، اطلاعات کاربر رو داخل یه object داریم.
یه نکته هم وجود داره: اگر $lookup هیچ Userای پیدا نکنه، $unwind به شکل پیشفرض اون Request رو از خروجی حذف میکنه.
اگر نخوایم این اتفاق بیفته:
{
  $unwind: {
    path: '$requester',
    preserveNullAndEmptyArrays: true,
  },
}
این موضوع مخصوصا وقتی یه سری اطلاعات مرتبط حذف شده باشند مهم میشه.
$addFields؛ ساخت فیلدهای محاسباتی
یکی از کاربردیترین Stageها برای منطقهایی که داخل Query داریم، $addFields هست.
فرض کنیم یه Request این دو فیلد رو داره:
{
  price: 100,
  quantity: 3
}
میخوایم قیمت کل رو حساب کنیم:
{
  $addFields: {
    totalPrice: {
      $multiply: [
        '$price',
        '$quantity'
      ]
    }
  }
}
حالا خروجی این فیلد رو هم داره:
{
  price: 100,
  quantity: 3,
  totalPrice: 300
}
در واقع Document اصلی رو نگه میداریم و یه مقدار جدید بهش اضافه میکنیم.
علامت $ قبل از اسم فیلد هم یعنی مقدار اون فیلد رو از Document بخون.
مثلا:
'$price'
یعنی مقدار فیلد price، نه رشتهی "price".
از $addFields فقط برای محاسبات عددی استفاده نمیکنیم. میتونیم boolean، string، array یا حتی object جدید بسازیم.
بررسی اینکه کاربر بالای ۱۸ سال هست یا نه
فرض کنیم بعد از $lookup اطلاعات User رو داخل requester داریم:
{
  requester: {
    profile: {
      birthDate: ISODate("2000-05-10")
    }
  }
}
میخوایم یه فیلد به اسم isAdult اضافه کنیم.
یه راه اینه که با $dateDiff اختلاف تاریخ تولد و امروز رو به سال حساب کنیم؛ ولی اینجا یه نکته وجود داره.
$dateDiff با unit: 'year' تعداد مرزهای سال تقویمی رو میشماره، نه تعداد تولدهایی که واقعا گذشته.
مثلا فاصلهی آخرین روز یک سال تا اولین روز سال بعد ممکنه از دید $dateDiff یک سال باشه، در حالی که فقط یک روز گذشته.
برای همین بهتره تاریخ تولد رو با ۱۸ سال قبل از امروز مقایسه کنیم:
{
  $addFields: {
    isAdult: {
      $and: [
        {
          $eq: [
            { $type: '$requester.profile.birthDate' },
            'date',
          ],
        },
        {
          $lte: [
            '$requester.profile.birthDate',
            {
              $dateSubtract: {
                startDate: '$$NOW',
                unit: 'year',
                amount: 18,
                timezone: 'Asia/Tehran',
              },
            },
          ],
        },
      ],
    },
  },
}
اینجا دو شرط داریم:
اول بررسی میکنیم birthDate واقعا از نوع Date باشه. بعد میبینیم تاریخ تولد قبل یا مساوی ۱۸ سال قبل هست یا نه.
برای قوانین وابسته به روز تولد، باید نحوهی ذخیرهی birthDate و timezone هم یکسان باشه.
بررسی وجود یه فیلد با $type
حالا فرض کنیم میخوایم بررسی کنیم کاربر یه فایل آپلود کرده یا نه.
مثلا فیلد filename داریم.
داخل $match میتونیم از $exists استفاده کنیم، ولی داخل Expressionهای $addFields این Operator رو به همون شکل نداریم.
اینجا $type به کار میاد:
{
  $addFields: {
    hasAttachment: {
      $ne: [
        { $type: '$filename' },
        'missing',
      ],
    },
  },
}
اگر فیلد وجود نداشته باشه، $type مقدار "missing" برمیگردونه.
ولی این شرط یه تفاوت مهم داره:
{ filename: "document.pdf" } // true
{ filename: null }           // true
{ filename: "" }             // true
{}                           // false
چون صرفا وجود فیلد بررسی میشه.
اگر بخوایم فایل واقعا اسم داشته باشه و filename از نوع String باشه:
{
  $addFields: {
    hasAttachment: {
      $and: [
        {
          $eq: [
            { $type: '$filename' },
            'string',
          ],
        },

        {
          $ne: ['$filename', ''],
        },
      ],
    },
  },
}
البته اگر رشتهای شامل فقط فاصله هم نامعتبر باشه، باید اون رو هم جداگانه بررسی کنیم.
$expr؛ وقتی شرط فقط مقایسه با یه مقدار ثابت نیست
داخل $match معمولا Queryهایی مثل این مینویسیم:
{
  $match: {
    status: 'approved',
    price: { $gte: 100 },
  },
}
ولی فرض کنیم میخوایم دو تا فیلد رو با هم مقایسه کنیم.
مثلا:
{
  price: 150,
  budget: 200
}
میخوایم فقط documentهایی رو پیدا کنیم که قیمتشون کمتر از budget هست.
اینجا میتونیم از $expr استفاده کنیم:
{
  $match: {
    $expr: {
      $lt: [
        '$price',
        '$budget'
      ]
    }
  }
}
یعنی:
price < budget
یا مثلا بخوایم درخواستهای ۱۰ روز اخیر رو بگیریم:
{
  $match: {
    $expr: {
      $gte: [
        '$createdAt',
        {
          $dateSubtract: {
            startDate: '$$NOW',
            unit: 'day',
            amount: 10,
          },
        },
      ],
    },
  },
}
اینجا داریم میگیم:
createdAt >= now - 10 days
یه نکتهی مهم اینه که اگر تاریخ موردنظر رو از قبل توی Node.js محاسبه کرده باشیم، میتونیم شرط سادهتری بنویسیم:
const tenDaysAgo = new Date(
  Date.now() - 10 * 86_400_000
);

const requests = await Request.find({
  createdAt: {
    $gte: tenDaysAgo,
  },
});
این فرم معمولا برای فیلتر سادهی تاریخ خواناتر هست و میتونه راحتتر از index استفاده کنه.
پس قرار نیست برای هر شرطی از $expr استفاده کنیم. بیشتر وقتی بهش نیاز داریم که داخل شرط یه Expression یا محاسبه داشته باشیم.
$switch؛ نوشتن شرطهای چندحالته
یه سناریوی واقعی رو در نظر بگیریم.
فرض کنیم Contract داریم و میخوایم براساس وضعیت و تاریخ انقضاش، نوع Alert رو مشخص کنیم.
مثلا سه نوع هشدار داریم:
expired
nearExpiry
requiresAction
منطقش هم اینه:
- اگر تاریخ قرارداد گذشته یا وضعیتش expired باشه، هشدار انقضا داشته باشیم.
- اگر approved باشه و تا ۳۰ روز آینده منقضی بشه، nearExpiry باشه.
- اگر pending یا suspended باشه، نیاز به بررسی داشته باشه.
برای این مدل شرطها میتونیم از $switch استفاده کنیم:
{
  $addFields: {
    alertType: {
      $switch: {
        branches: [
          {
            case: {
              $or: [
                { $eq: ['$status', 'expired'] },
                { $lt: ['$validityEndDate', now] },
              ],
            },
            then: 'expired',
          },

          {
            case: {
              $and: [
                { $eq: ['$status', 'approved'] },
                { $gte: ['$validityEndDate', now] },
                { $lte: ['$validityEndDate', deadline] },
              ],
            },
            then: 'nearExpiry',
          },

          {
            case: {
              $in: [
                '$status',
                ['pending', 'suspended'],
              ],
            },
            then: 'requiresAction',
          },
        ],

        default: null,
      },
    },
  },
}
تقریبا معادل همون if / else if / else داخل JavaScript هست.
فقط یه نکته: ترتیب Branchها خیلی مهمه.
$switch از بالا به پایین شرطها رو بررسی میکنه و اولین شرطی که برقرار باشه انتخاب میشه.
مثلا اگر قرارداد suspended باشه ولی تاریخش هم گذشته باشه، طبق همین منطق expired میشه، نه requiresAction.
پس ترتیب شرطها باید براساس اولویت Business Logic باشه.
محاسبه اختلاف تاریخ داخل Aggregation
فرض کنیم علاوه بر نوع Alert، میخوایم بدونیم چند روز تا انقضای قرارداد باقی مونده.
{
  $addFields: {
    daysUntilExpiration: {
      $ceil: {
        $divide: [
          {
            $subtract: [
              '$validityEndDate',
              now,
            ],
          },
          86_400_000,
        ],
      },
    },
  },
}
اینجا $subtract اختلاف دو تاریخ رو به میلیثانیه برمیگردونه.
بعد تقسیمش میکنیم بر تعداد میلیثانیههای یک روز:
1000 × 60 × 60 × 24
= 86,400,000
و با $ceil عدد رو به سمت بالا گرد میکنیم.
مثلا:
2.3 days → 3
-2.3 days → -2
همین نکتهی دوم مهمه؛ $ceil برای اعداد منفی به سمت صفر حرکت میکنه. اگر قرار باشه تعداد روزهای گذشته رو به شکل دیگهای محاسبه کنیم، باید منطق گرد کردن رو عوض کنیم.
از طرف دیگه، این فرمول براساس بازههای ۲۴ساعته کار میکنه. اگر اختلاف روزهای تقویمی مدنظر باشه، ممکنه استفاده از Date Operatorهایی مثل $dateDiff همراه با timezone مناسبتر باشه.
$facet؛ چند خروجی از یک Query
به نظرم یکی از کاربردیترین بخشهای Aggregation برای APIهایی که Dashboard دارن، $facet هست.
فرض کنیم یه لیست از Alertها داریم و میخوایم همزمان این اطلاعات رو برگردونیم:
data    → اطلاعات صفحه فعلی
total   → تعداد کل نتایج
byType  → تعداد هشدارها بر اساس نوع
بدون $facet شاید برای هر کدوم یه Query جدا بنویسیم.
ولی با $facet میتونیم از یک Dataset چند خروجی بسازیم:
{
  $facet: {
    data: [
      { $skip: (page - 1) * limit },
      { $limit: limit },
    ],

    total: [
      { $count: 'count' },
    ],

    byType: [
      {
        $group: {
          _id: '$alertType',
          count: { $sum: 1 },
        },
      },
    ],
  },
}
اینجا هر سه Pipeline بهصورت مستقل اطلاعات ورودی یکسانی رو دریافت میکنن.
خروجی تقریبا این شکلی میشه:
[
  {
    data: [
      // Current page documents
    ],

    total: [
      { count: 125 }
    ],

    byType: [
      { _id: "expired", count: 40 },
      { _id: "nearExpiry", count: 65 },
      { _id: "requiresAction", count: 20 }
    ]
  }
]
برای گرفتن نتیجه توی Mongoose:
const [result] = await ContractModel.aggregate(pipeline);

const total = result?.total?.[0]?.count ?? 0;
علت استفاده از [0] اینه که خروجی aggregate یه آرایه هست و $facet هم خروجی هر Branch رو داخل آرایه نگه میداره.
یه نکته درباره ترتیب $match و $facet
فرض کنیم قبل از $facet این شرط رو بذاریم:
{
  $match: {
    alertType: 'expired',
  },
}
حالا تمام Branchهای $facet فقط هشدارهای expired رو میبینن.
پس اگر Dashboard باید تعداد کل نوعهای Alert رو نشون بده، حتی وقتی فیلتر فعلی روی expired هست، این Query مناسب نیست.
راه بهتر اینه که فیلتر مربوط به data و total رو داخل Branchهای خودشون قرار بدیم و byType رو روی کل Alertها حساب کنیم.
{
  $facet: {
    data: [
      { $match: { alertType: 'expired' } },
      { $sort: { createdAt: -1, _id: 1 } },
      { $skip: 0 },
      { $limit: 20 },
    ],

    total: [
      { $match: { alertType: 'expired' } },
      { $count: 'count' },
    ],

    byType: [
      {
        $group: {
          _id: '$alertType',
          count: { $sum: 1 },
        },
      },
    ],
  },
}
اینطوری فیلتر صفحه روی summary کلی اثر نمیذاره.
البته $facet هم محدودیت حافظه داره و نباید صرفا برای اینکه چند خروجی لازم داریم، بدون توجه به حجم Dataset ازش استفاده کنیم.
$group و اشتباهی که موقع Count ممکنه پیش بیاد
فرض کنیم هر Request یه operationType داره:
{
  operationType: "IMPORT"
}
میخوایم تعداد Requestها رو براساس operationType حساب کنیم.
{
  $group: {
    _id: '$operationType',

    total: {
      $sum: 1,
    },
  },
}
برای هر Document یکی به Count اون Group اضافه میشه.
ولی اگر بنویسیم:
{
  $group: {
    _id: '$operationType',

    total: {
      $sum: '$operationType',
    },
  },
}
در صورتی که operationType از نوع String باشه، نتیجهی موردنظر رو نمیگیریم؛ چون $sum برای جمع مقادیر عددی استفاده میشه.
برای جمع یه فیلد عددی مثل مبلغ سفارش:
{
  $group: {
    _id: '$userId',

    totalSpent: {
      $sum: '$totalAmount',
    },

    orderCount: {
      $sum: 1,
    },
  },
}
پس:
$sum: 1
→ تعداد documentها
$sum: '$totalAmount'
→ مجموع مبلغها
یه Aggregation واقعی با چند Stage
حالا فرض کنیم میخوایم Requestهای ۱۰ روز اخیر رو بررسی کنیم.
شرطها اینها هستن:
- درخواست مربوط به ۱۰ روز اخیر باشه.
- اطلاعات User با
$lookupدریافت بشه. - User حداقل ۱۸ سال داشته باشه.
- مشخص کنیم Attachment داره یا نه.
- در نهایت Requestها رو براساس operationType گروهبندی کنیم.
import type { PipelineStage } from 'mongoose';

const tenDaysAgo = new Date(
  Date.now() - 10 * 86_400_000
);

const pipeline: PipelineStage[] = [
  {
    $match: {
      createdAt: {
        $gte: tenDaysAgo,
      },
    },
  },

  {
    $lookup: {
      from: 'users',
      localField: 'requestBy',
      foreignField: '_id',
      as: 'requester',
    },
  },

  {
    $unwind: '$requester',
  },

  {
    $addFields: {
      isAdult: {
        $and: [
          {
            $eq: [
              { $type: '$requester.profile.birthDate' },
              'date',
            ],
          },
          {
            $lte: [
              '$requester.profile.birthDate',
              {
                $dateSubtract: {
                  startDate: '$$NOW',
                  unit: 'year',
                  amount: 18,
                  timezone: 'Asia/Tehran',
                },
              },
            ],
          },
        ],
      },

      hasAttachment: {
        $and: [
          {
            $eq: [
              { $type: '$filename' },
              'string',
            ],
          },
          {
            $ne: ['$filename', ''],
          },
        ],
      },
    },
  },

  {
    $match: {
      isAdult: true,
    },
  },

  {
    $facet: {
      data: [
        { $sort: { createdAt: -1, _id: 1 } },
        { $limit: 20 },
      ],

      total: [
        { $count: 'count' },
      ],

      byOperationType: [
        {
          $group: {
            _id: '$operationType',
            count: { $sum: 1 },
          },
        },
      ],
    },
  },
];

const [result] = await Request.aggregate(pipeline);
نکتهای که توی این مدل Queryها مهمه، ترتیب Stageها هست.
مثلا نمیتونیم قبل از $lookup روی requester.profile.birthDate شرط بذاریم، چون هنوز اطلاعات User دریافت نشده.
یا قبل از $addFields نمیتونیم براساس isAdult فیلتر کنیم، چون این فیلد هنوز ساخته نشده.
چرا نباید بیدلیل $limit بذاریم؟
گاهی برای اینکه Query سنگین نشه، یه چیزی مثل این میذاریم:
{
  $limit: 1000000,
}
ولی اگر این Stage قبل از $lookup و فیلترهای اصلی باشه، ممکنه بخشی از اطلاعات اصلا بررسی نشه.
از طرف دیگه، اگر قبلش Sort نداشته باشیم، تضمینی نداریم که دقیقا جدیدترین Documentها انتخاب بشن.
پس بهتره محدود کردن نتایج رو براساس نیاز واقعی انجام بدیم، نه صرفا گذاشتن یه عدد بزرگ.
آپدیت کردن یه عضو مشخص از Array
یه سناریوی دیگه که توی MongoDB زیاد بهش برمیخوریم، آپدیت Documentها براساس یه عضو مشخص از آرایه هست.
مثلا فرض کنیم:
{
  processPermission: [
    { status: 1 },
    { status: 1 },
    { status: 0 }
  ],

  currentStep: 2
}
میخوایم Requestهایی رو پیدا کنیم که عضو دوم آرایه processPermission وضعیت ۱ داره.
const filter = {
  'processPermission.1.status': 1,
};
حالا اگر بخوایم فقط همون عضو رو آپدیت کنیم:
await Request.updateMany(
  filter,
  {
    $set: {
      'processPermission.1.status': 2,
    },
  },
);
ولی اگر بخوایم براساس این شرط، فیلدهای اصلی Request رو تغییر بدیم:
await Request.updateMany(
  filter,
  {
    $set: {
      requestStatus: 2,
      currentStep: 3,
    },
  },
);
یه نکتهی مهم اینکه این Query همهی Documentهایی که شرط رو دارند تغییر میده.
پس بهتره قبل از اجرا تعدادشون رو بررسی کنیم:
const count = await Request.countDocuments(filter);
و برای تغییرات حساس، اول با find نمونهی Documentهای هدف رو ببینیم. مخصوصا وقتی داریم روی دیتای Production عملیات گروهی انجام میدیم.
مدیریت Date و تاریخ شمسی داخل MongoDB
یه موضوع دیگه مربوط به زمانهایی هست که هم Date میلادی ذخیره میکنیم و هم نسخهی String تاریخ شمسی رو.
مثلا:
permitStartDate?: Date;
permitStartDateString?: string;

permitEndDate?: Date;
permitEndDateString?: string;
یه اشتباه ممکن اینه که مقدار Date و String رو جداگانه بسازیم و بهمرور با هم ناهماهنگ بشن.
بهتره Date رو منبع اصلی اطلاعات در نظر بگیریم و رشتهی شمسی رو از همون مقدار تولید کنیم.
مثلا:
const formatPersianDate = (date: Date) => {
  const formatter = new Intl.DateTimeFormat(
    'en-US-u-ca-persian',
    {
      timeZone: 'Asia/Tehran',
      year: 'numeric',
      month: '2-digit',
      day: '2-digit',
      hour: '2-digit',
      minute: '2-digit',
      hourCycle: 'h23',
    }
  );

  const parts = Object.fromEntries(
    formatter
      .formatToParts(date)
      .map(({ type, value }) => [type, value])
  );

  return [
    `${parts.year}/${parts.month}/${parts.day}`,
    `${parts.hour}:${parts.minute}`,
  ].join(' ');
};
حالا فرض کنیم میخوایم اعتبار یه مجوز رو تا پایان سال شمسی ۱۴۰۵ تنظیم کنیم.
const permitStartDate = new Date(
'2026-10-16T10:00:00+03:30'
);
// شروع سال بعد به وقت تهران
const endExclusive = new Date(
'2027-03-21T00:00:00+03:30'
);
// آخرین میلیثانیه سال ۱۴۰۵
const permitEndDate = new Date(
endExclusive.getTime() - 1
);
بعد:
await Request.updateMany(
  {
    'processPermission.1.status': 1,
  },
  {
    $set: {
      allowedGates: [gateId],

      permitStartDate,
      permitStartDateString:
        formatPersianDate(permitStartDate),

      permitEndDate,
      permitEndDateString:
        formatPersianDate(permitEndDate),
    },
  },
);
اینجا gateId باید یه ObjectId معتبر باشه.
این روش باعث میشه تاریخها از یه منبع مشترک ساخته بشن.
یه نکتهی طراحی هم اینکه اگر اختیار Schema رو داشته باشیم، بهتره تا جای ممکن Date رو ذخیره کنیم و تاریخ شمسی رو موقع نمایش بسازیم.
چون اگر هر دو مقدار رو ذخیره کنیم، باید همیشه حواسمون به Sync بودنشون هم باشه.
برای بررسی بازههای زمانی هم الگوی start <= date < endExclusive معمولا تمیزتر از محاسبهی آخرین میلیثانیهی روز هست.
چند نکته درباره Performance
Aggregation خیلی قدرتمنده، ولی این به معنی سریع بودن تمام Queryهایی که باهاش مینویسیم نیست.
مثلا اگر روی چند میلیون Document یه $lookup یا $group سنگین اجرا کنیم، باید به حجم Dataset و indexها توجه کنیم.
چند مورد که معمولا خوبه حواسمون بهشون باشه:
فیلتر کردن زودتر اطلاعات
اگر Query از ابتدا میدونه فقط Requestهای ۱۰ روز اخیر رو لازم داره، بهتره تا جای ممکن همون ابتدا $match انجام بشه تا Documentهای کمتری وارد مراحل بعدی بشن.
استفاده از Index
مثلا اگر زیاد براساس createdAt Query میزنیم:
db.requests.createIndex({
  createdAt: -1
})
البته اینکه چه indexای مناسبتره کاملا به Queryهای واقعی اپلیکیشن بستگی داره.
استفاده از explain()
برای بررسی نحوهی اجرای Query:
db.requests.explain('executionStats').aggregate([
  {
    $match: {
      status: 'approved'
    }
  }
])
میتونیم بررسی کنیم MongoDB از Index استفاده کرده یا Collection Scan انجام داده.
مرتبسازی قبل از Pagination
اگر میخوایم اطلاعات رو صفحهبندی کنیم، بهتره Sort مشخص و پایداری داشته باشیم.
مثلا:
{
  $sort: {
    createdAt: -1,
    _id: 1
  }
}
وجود _id برای شکستن تساوی بین Documentهایی که createdAt یکسان دارن مفیده.
و برای Datasetهای بزرگ هم pagination مبتنی بر cursor میتونه از skipهای خیلی بزرگ مناسبتر باشه.
در نهایت
به نظرم مهمترین نکته درباره Aggregation اینه که لازم نیست همهی Operatorها رو حفظ کنیم.
بیشتر باید بدونیم توی هر مرحله قرار هست چه کاری با دادهها انجام بدیم.
مثلا وقتی میخوایم یه Query پیچیده بنویسیم، اول میتونیم مسئله رو این شکلی بشکنیم:
1. چه Documentهایی لازم داریم؟
↓
$match
2. از Collection دیگه اطلاعات میخوایم؟
↓
$lookup
3. خروجی Join آرایه هست؟
↓
$unwind
4. باید Field جدید محاسبه کنیم؟
↓
$addFields
5. شرط محاسباتی داریم؟
↓
$expr / $switch
6. میخوایم اطلاعات رو Group کنیم؟
↓
$group
7. چند خروجی مثل Data و Count لازم داریم؟
↓
$facet
البته قرار نیست همیشه تمام این Stageها رو داشته باشیم. بعضی وقتها یه find ساده همون کاری رو انجام میده که میخوایم.
ولی وقتی Queryها بزرگتر میشن، اگر از ابتدا مسئله رو به چند مرحله مستقل بشکنیم، هم نوشتن Query راحتتر میشه و هم Debug کردنش.
و یه نکتهی آخر: درست کار کردن Query روی چندتا Document آزمایشی، لزوما به معنی درست و بهینه بودنش روی دیتای واقعی نیست.
مخصوصا وقتی با Date، Array، $lookup، Pagination و عملیات گروهی مثل updateMany کار میکنیم، باید حواسمون به حالتهای خاص و رفتار Query روی دیتای Production هم باشه.
اینها یه سری نکته از کار با MongoDB Query و Aggregation بودن که بهنظرم بد نیست موقع نوشتن Queryهای پیچیدهتر در نظر بگیریم.