فرض کنیم داریم بکاند یک فروشگاه اینترنتی رو مینویسیم. یوزرها ثبتنام میکنند، محصول انتخاب میکنند و سفارش میزنند. اول کار شاید وسوسه بشیم همهچیز رو داخل یک جدول یا یک Document ذخیره کنیم؛ چون هم سریعتره، هم ظاهراً کوئری زدن راحتتر میشه.
اما وقتی تعداد سفارشها بالا بره یا اطلاعات یک محصول تغییر کنه، تازه متوجه میشیم طراحی دیتابیس چقدر مهم بوده.
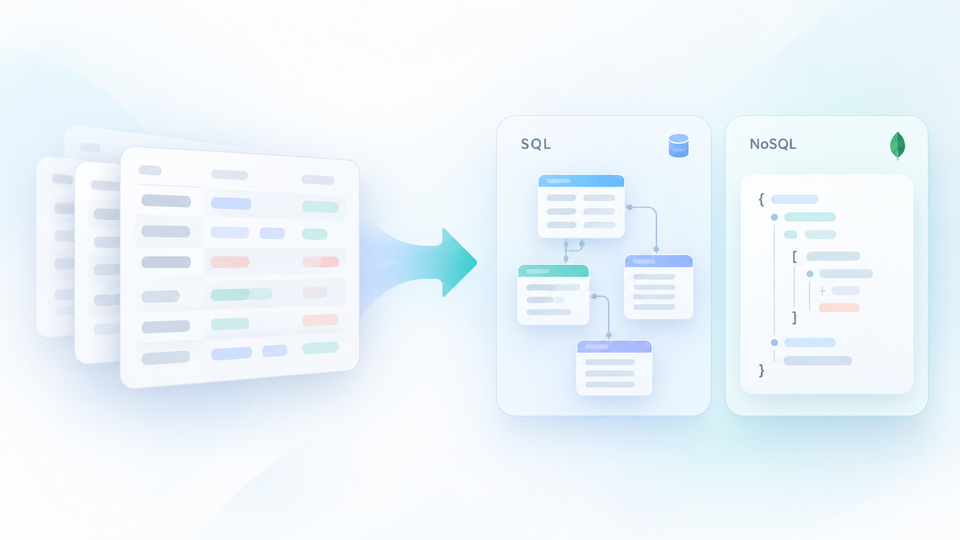
توی این مقاله میخوایم اول نرمالسازی پایگاه داده (Database Normalization) رو از 0NF تا 5NF بررسی کنیم. بعد با SQLAlchemy 2.x و Mapped، mapped_column و relationship یک مدل رابطهای درست میکنیم. در نهایت هم همون سناریو رو با PyMongo پیاده میکنیم تا بفهمیم چرا طراحی درست در MongoDB لزوماً شبیه دیتابیسهای SQL نیست.
نرمالسازی دیتابیس اصلاً چه مشکلی رو حل میکنه؟
فرض کنیم جدول زیر رو داریم:
| order_id | customer_name | customer_city | products |
|---|---|---|---|
| 101 | Ali | Tehran | Keyboard, Mouse |
| 102 | Sara | Shiraz | Monitor |
| 103 | Ali | Tehran | Mouse, Monitor |
این طراحی در نگاه اول سادهست، ولی چند مشکل مهم داره:
- Update Anomaly: اگر شهر Ali تغییر کنه باید چند ردیف رو آپدیت کنیم.
- Insert Anomaly: ممکنه نتونیم محصولی رو که هنوز فروخته نشده مستقل ثبت کنیم.
- Delete Anomaly: با حذف آخرین سفارش یک محصول، ممکنه تنها اطلاعات اون محصول رو هم از دست بدیم.
- Data Redundancy: اطلاعات مشتری و محصول بارها تکرار میشن.
هدف نرمالسازی اینه که دادهها رو براساس وابستگیهاشون سازماندهی کنیم؛ نه اینکه صرفاً تعداد جدولها رو زیاد کنیم.
از 0NF تا 5NF: قدمبهقدم
0NF: دادهها هنوز ساختار مناسبی ندارند
جدول بالا یک نمونه از داده نرمالنشدهست، چون داخل products یک لیست از چند محصول داریم. در یک طراحی رابطهای استاندارد بهتره هر محصول سفارش، ردیف خودش رو داشته باشه.
1NF: هر مقدار در جای خودش
جدول رو به این شکل تبدیل میکنیم:
| order_id | customer | city | product_id | product | quantity |
|---|---|---|---|---|---|
| 101 | Ali | Tehran | 1 | Keyboard | 2 |
| 101 | Ali | Tehran | 2 | Mouse | 1 |
| 102 | Sara | Shiraz | 3 | Monitor | 1 |
| 103 | Ali | Tehran | 2 | Mouse | 3 |
فرض میکنیم هر محصول حداکثر یکبار در هر سفارش ثبت میشه. پس (order_id, product_id) میتونه کلید مرکب این جدول باشه.
در 1NF باید گروههای تکرارشونده رو حذف کنیم و مقادیر ستونها رو در دامنهای مشخص و بهصورت یک مقدار واحد ذخیره کنیم. اما تکرار نام و شهر مشتری همچنان باقیه.
2NF: وابستگی به تمام کلید، نه بخشی از اون
در جدول قبلی کلید مرکب داریم:
(order_id, product_id)اما همه ستونها به کل کلید وابسته نیستند:
product_id → product_name
order_id → customer_id
(order_id, product_id) → quantity
به این وضعیت Partial Dependency میگیم. در 2NF باید جدول در 1NF باشه و ویژگی غیرکلیدی به بخشی از یک کلید کاندید مرکب وابسته نباشه.
پس اطلاعات محصول رو به products، اطلاعات سفارش رو به orders و تعداد هر محصول رو به order_items انتقال میدیم.
3NF: وابستگی انتقالی رو هم حذف کنیم
حالا فرض کنیم در جدول orders این فیلدها رو داریم:
order_id, customer_id, customer_name, customer_cityوابستگیها اینطوریاند:
order_id → customer_id
customer_id → customer_name, customer_city
اسم و شهر مشتری مشخصههای خود مشتریاند، نه سفارش. اینجا یک Transitive Dependency مشکلساز داریم. راهحل اینه که مشتری رو در جدول مستقل customers نگه داریم و داخل orders فقط به شناسهاش ارجاع بدیم.
ساختار نهایی ما میشه:
customers(id, email, name, city)
products(id, sku, name)
orders(id, customer_id, ordered_at)
order_items(order_id, product_id, quantity, unit_price_cents)
البته در مدل واقعی میتونیم unit_price_cents رو داخل order_items نگه داریم، چون قیمت هنگام خرید یک واقعیت تاریخی مربوط به همون آیتم سفارشه و نباید با تغییر قیمت فعلی محصول عوض بشه.
برای اکثر پروژههای CRUD، رسیدن به 3NF نقطه شروع خوبیه؛ ولی هنوز سطحهای سختگیرانهتری وجود داره.
BCNF: تعیینکننده باید Superkey باشه
BCNF میگه در هر وابستگی تابعی غیر بدیهی مثل X → Y، سمت چپ یعنی X باید یک Superkey باشه.
مثلاً فرض کنیم هر استاد دقیقاً یک درس تدریس میکنه، یک درس ممکنه چند استاد داشته باشه و هر دانشجو برای هر درس فقط یک استاد انتخاب میکنه:
student_id, course_id, teacher_id

(student_id, course_id) → teacher_id
teacher_id → course_id
اینجا teacher_id بهتنهایی Superkey نیست، پس با وجود اینکه این جدول میتونه در 3NF باشه، شرط BCNF رو نقض میکنه. در چنین سناریویی میتونیم رابطه استاد و درس رو جدا بررسی کنیم.
4NF: چند وابستگی مستقل رو قاطی نکنیم
فرض کنیم هر یوزر چند زبان بلده و چند سرگرمی داره و این دو مجموعه کاملاً مستقلاند:
| user_id | language | hobby |
|---|---|---|
| 1 | Persian | Chess |
| 1 | Persian | Football |
| 1 | English | Chess |
| 1 | English | Football |
بهجای ذخیره تمام ترکیبها، دو رابطه مستقل درست میکنیم: user_languages(user_id, language) و user_hobbies(user_id, hobby).
4NF درباره وابستگیهای چندمقداری غیر بدیهیه؛ یعنی وقتی چند مجموعه مستقل داریم، نباید مجبور بشیم ترکیب مصنوعی همه اونها رو نگه داریم.
5NF: تجزیه بدون از دست دادن رابطهها
5NF سراغ Join Dependency میره. مثلاً رابطه سهتایی بین supplier، part و project رو در نظر بگیریم. فقط وقتی میتونیم اون رو به چند رابطه کوچکتر بشکنیم که Join اونها دقیقاً داده اصلی رو بازسازی کنه و ترکیب اشتباه نسازه. این شرط باید از قوانین واقعی کسبوکار بیاد؛ با حدس نمیشه هر جدول سهستونهای رو تجزیه کرد.
پس 5NF الزاماً «بهترین طراحی برای همه پروژهها» نیست. گاهی 3NF یا BCNF هم صحیحتره و هم نگهداری سادهتری داره.
پیادهسازی مدل نرمالشده با SQLAlchemy 2.x
اینجا میخوایم همون فروشگاه رو با ORM بسازیم. در SQLAlchemy سه چیز رو باید از هم تفکیک کنیم:
Mapped[T]: نوع ویژگیای که ORM مدیریت میکنه.mapped_column(): تعریف و تنظیم ستون دیتابیس، مثل Primary Key و Foreign Key.relationship(): دسترسی پایتونی به موجودیتهای مرتبط.
برای نصب:
pip install "SQLAlchemy>=2.0,<3"مدلهای نهایی: Customer، Product، Order و OrderItem
from __future__ import annotations

from datetime import datetime
from sqlalchemy import ForeignKey, String, create_engine, select
from sqlalchemy.orm import (
    DeclarativeBase,
    Mapped,
    Session,
    mapped_column,
    relationship,
    selectinload,
)


class Base(DeclarativeBase):
    pass


class Customer(Base):
    __tablename__ = "customers"

    id: Mapped[int] = mapped_column(primary_key=True)
    email: Mapped[str] = mapped_column(String(120), unique=True)
    name: Mapped[str] = mapped_column(String(100))
    city: Mapped[str] = mapped_column(String(100))

    orders: Mapped[list[Order]] = relationship(back_populates="customer")


class Product(Base):
    __tablename__ = "products"

    id: Mapped[int] = mapped_column(primary_key=True)
    sku: Mapped[str] = mapped_column(String(30), unique=True)
    name: Mapped[str] = mapped_column(String(100))

    items: Mapped[list[OrderItem]] = relationship(back_populates="product")


class Order(Base):
    __tablename__ = "orders"

    id: Mapped[int] = mapped_column(primary_key=True)
    customer_id: Mapped[int] = mapped_column(ForeignKey("customers.id"))
    ordered_at: Mapped[datetime] = mapped_column(default=datetime.utcnow)

    customer: Mapped[Customer] = relationship(back_populates="orders")
    items: Mapped[list[OrderItem]] = relationship(
        back_populates="order", cascade="all, delete-orphan"
    )


class OrderItem(Base):
    __tablename__ = "order_items"

    order_id: Mapped[int] = mapped_column(
        ForeignKey("orders.id"), primary_key=True
    )
    product_id: Mapped[int] = mapped_column(
        ForeignKey("products.id"), primary_key=True
    )
    quantity: Mapped[int]
    unit_price_cents: Mapped[int]

    order: Mapped[Order] = relationship(back_populates="items")
    product: Mapped[Product] = relationship(back_populates="items")
نکته مهم اینجاست که رابطه بین Order و Product در ظاهر Many-to-Many محسوب میشه، اما چون خود رابطه ویژگیهایی مثل quantity و unit_price_cents داره، از یک Association Object به نام OrderItem استفاده کردیم؛ نه یک جدول واسط ساده با secondary.
انتقال داده از ساختار بد به ساختار درست
فرض کنیم خروجی Legacy Database بهشکل زیر باشه. هر ردیف، اطلاعات مشتری و محصول رو دوباره ذخیره کرده:
legacy_rows = [
    dict(order_id=101, email="ali@example.test", name="Ali", city="Tehran",
         sku="KB", product="Keyboard", quantity=2, price=2500),
    dict(order_id=101, email="ali@example.test", name="Ali", city="Tehran",
         sku="MS", product="Mouse", quantity=1, price=1200),
    dict(order_id=102, email="sara@example.test", name="Sara", city="Shiraz",
         sku="MN", product="Monitor", quantity=1, price=15000),
]

engine = create_engine("sqlite+pysqlite:///:memory:")
Base.metadata.create_all(engine)

with Session(engine) as session:
    customers = {}
    products = {}
    orders = {}

    for row in legacy_rows:
        if row["email"] not in customers:
            customers[row["email"]] = Customer(
                email=row["email"], name=row["name"], city=row["city"]
            )
        if row["sku"] not in products:
            products[row["sku"]] = Product(
                sku=row["sku"], name=row["product"]
            )
        if row["order_id"] not in orders:
            orders[row["order_id"]] = Order(
                id=row["order_id"], customer=customers[row["email"]]
            )

        orders[row["order_id"]].items.append(
            OrderItem(
                product=products[row["sku"]],
                quantity=row["quantity"],
                unit_price_cents=row["price"],
            )
        )

    session.add_all(orders.values())
    session.commit()
با این کار Ali فقط یک رکورد در customers داره، Mouse فقط یک رکورد در products داره و اقلام سفارش هم با Foreign Key به هم متصل میشن.
این یک Migration آموزشی برای داده تمیز و محدود است. برای Production باید داده ناسازگار، رکورد تکراری، برخورد کلیدها، تراکنش و قابلیت اجرای مجدد Migration رو هم بررسی کنیم.
خواندن سفارشها بدون افتادن در دام N+1
with Session(engine) as session:
    stmt = (
        select(Order)
        .options(
            selectinload(Order.customer),
            selectinload(Order.items).selectinload(OrderItem.product),
        )
        .order_by(Order.id)
    )

    for order in session.scalars(stmt):
        print("Order:", order.id, "Customer:", order.customer.name)
        for item in order.items:
            print(item.product.name, item.quantity, item.unit_price_cents)
از selectinload استفاده کردیم تا ORM مجبور نشه برای هر سفارش و هر آیتم، Query جداگانهای اجرا کنه. همچنین تغییر شهر مشتری فقط یک Update روی جدول customers میخواد.
One-to-One و Many-to-Many چی میشن؟
برای One-to-One مثلاً میتونیم User و Profile داشته باشیم. روی Foreign Key پروفایل unique=True میذاریم و سمت User از Mapped[Profile | None] استفاده میکنیم.
برای Many-to-Many ساده مثل Student و Course که هیچ اطلاعات اضافهای روی عضویت نداریم، یک Association Table و relationship(secondary=...) کافیه. اما اگر رابطه خودش داده داره، مثل نمره دانشجو یا قیمت سفارش، بهتره اون رابطه رو بهصورت یک مدل مستقل تعریف کنیم.
پیادهسازی سناریوی مشابه با PyMongo
تا اینجا درباره SQL صحبت کردیم. اما در MongoDB نباید همون منطق نرمالسازی SQL رو بدون فکر کپی کنیم.
MongoDB یک Document Database است. یعنی میتونیم داخل یک Document آرایه یا Object داشته باشیم و این لزوماً به معنی طراحی بد نیست.
طراحی بد: تمام سفارشهای کاربر در یک Document
legacy_customer = {
    "email": "ali@example.test",
    "name": "Ali",
    "city": "Tehran",
    "orders": [
        {
            "order_no": 101,
            "items": [
                {"sku": "KB", "name": "Keyboard", "quantity": 2, "price": 2500},
                {"sku": "MS", "name": "Mouse", "quantity": 1, "price": 1200},
            ],
        },
        {
            "order_no": 103,
            "items": [
                {"sku": "MS", "name": "Mouse", "quantity": 3, "price": 1200},
            ],
        },
    ],
}
در این سناریو قرار نیست آرایه سفارشها برای همیشه کوچک بمونه. یک مشتری ممکنه هزاران سفارش داشته باشه. وقتی آرایه بدون محدودیت رشد کنه، هم مدیریت و صفحهبندی سفارشها سختتر میشه و هم ممکنه به محدودیت اندازه Document برسیم. سقف اندازه یک BSON Document در MongoDB برابر 16 MiB است.
طراحی بهتر: ترکیب Embedding و Referencing
برای این فروشگاه سه Collection داریم:
customers: _id, email, name, city
products:  _id, sku, name
orders:    _id, order_no, customer_id, shipping_city, items[]
customer_id و product_id رو بهشکل Reference نگه میداریم، اما items داخل سفارش Embed میشه؛ چون معمولاً آیتمهای سفارش رو همراه خود سفارش میخوایم. همینطور قیمت و نام محصول در لحظه خرید رو بهعنوان Snapshot ذخیره میکنیم، چون تاریخچه سفارش نباید با تغییر کاتالوگ عوض بشه.
انتقال داده با PyMongo
برای نصب و اتصال:
pip install "pymongo>=4,<5"در این کد فرض میکنیم MongoDB روی localhost:27017 اجرا شده و legacy_customer همون دیکشنری بالاست:
from pymongo import MongoClient, ReturnDocument

client = MongoClient("mongodb://localhost:27017")
db = client["shop_blog_demo"]

db.customers.create_index("email", unique=True)
db.products.create_index("sku", unique=True)
db.orders.create_index("order_no", unique=True)
db.orders.create_index([("customer_id", 1), ("order_no", -1)])

customer = db.customers.find_one_and_update(
    {"email": legacy_customer["email"]},
    {"$setOnInsert": {
        "name": legacy_customer["name"],
        "city": legacy_customer["city"],
    }},
    upsert=True,
    return_document=ReturnDocument.AFTER,
)

for old_order in legacy_customer["orders"]:
    items = []
    for old_item in old_order["items"]:
        product = db.products.find_one_and_update(
            {"sku": old_item["sku"]},
            {"$setOnInsert": {"name": old_item["name"]}},
            upsert=True,
            return_document=ReturnDocument.AFTER,
        )
        items.append({
            "product_id": product["_id"],
            "name_at_purchase": old_item["name"],
            "quantity": old_item["quantity"],
            "unit_price_cents": old_item["price"],
        })

    db.orders.update_one(
        {"order_no": old_order["order_no"]},
        {"$setOnInsert": {
            "customer_id": customer["_id"],
            "shipping_city": legacy_customer["city"],
            "items": items,
        }},
        upsert=True,
    )
از upsert=True و ایندکسهای Unique استفاده کردیم تا اجرای دوباره این مثال، بهسادگی سند تکراری برای ایمیل، SKU یا شماره سفارش نسازه. البته اگر داده Legacy تغییر کنه، $setOnInsert اطلاعات قبلی رو بهروزرسانی نمیکنه؛ برای Migration واقعی باید سیاست اصلاح و تطبیق داده رو جدا مشخص کنیم.
حالا چطور سفارشهای یک مشتری رو میگیریم؟
customer = db.customers.find_one({"email": "ali@example.test"})

for order in db.orders.find({"customer_id": customer["_id"]}).sort("order_no", 1):
    print("Order:", order["order_no"])
    for item in order["items"]:
        print(item["name_at_purchase"], item["quantity"])
برخلاف SQLAlchemy، در PyMongo خبری از relationship(back_populates=...) نیست؛ ارتباط رو با شناسه و Query مدیریت میکنیم. برای Joinمانندها هم میتونیم از Aggregation و $lookup استفاده کنیم، اما قرار نیست برای هر داده مرتبطی حتماً $lookup بزنیم.
SQLAlchemy و PyMongo رو چطور مقایسه کنیم؟
| نیاز | SQLAlchemy / SQL | PyMongo / MongoDB |
|---|---|---|
| مشتری مستقل | جدول customers | Collection customers |
| سفارشهای مشتری | Foreign Key و relationship | فیلد customer_id |
| اقلام سفارش | جدول order_items | آرایه items داخل سفارش |
| اطلاعات محصول | جدول products | Collection products |
| حفظ قیمت زمان خرید | ستون در order_items | Snapshot در items |
| کنترل ارجاع | Foreign Key در دیتابیس | معمولاً با منطق اپلیکیشن |
| خواندن ارتباطها | JOIN / ORM loaders | Reference query / $lookup / Embedding |
در SQL معمولاً از Entityها و Dependencyها شروع میکنیم. در MongoDB علاوه بر Entityها، باید Query Pattern رو هم جدی بگیریم؛ یعنی بررسی کنیم چه دادههایی بیشتر با هم خوانده میشن، چه چیزهایی مستقلاً آپدیت میشن و کدوم آرایه ممکنه بدون محدودیت رشد کنه.
چند اشتباه رایج که بهتره انجام ندیم
- هر تکراری رو اشتباه فرض نکنیم. مثلاً قیمت هنگام خرید باید مستقل از قیمت امروز محصول ثبت بشه.
- نرمالسازی بیشتر رو همیشه بهتر ندونیم. تعداد Joinها، خوانایی کد و نیاز واقعی کسبوکار هم مهمه.
- در MongoDB همهچیز رو Embed نکنیم. اگر داده مستقل و پرحجم یا مجموعهای با رشد نامحدود داریم، Reference معمولاً مناسبتره.
- در SQLAlchemy فقط Foreign Key تعریف نکنیم و منتظر دسترسی شیءمحور باشیم. برای نوشتن
order.customerیاcustomer.ordersبهrelationship()نیاز داریم. - Migration رو فقط یک Loop ساده در نظر نگیریم. اعتبارسنجی داده قبل و بعد انتقال، کنترل خطا، Backup، تراکنش مناسب و Idempotency برای سیستم واقعی ضروریاند.
جمعبندی
نرمالسازی دیتابیس صرفاً یک بحث تئوری درباره 1NF و 2NF و 3NF نیست. هر تصمیمی که امروز برای ساختار دادهها میگیریم، روی Queryها، Updateها و نگهداری سیستم در آینده تأثیر میذاره.
اگر با SQLAlchemy کار میکنیم، معمولاً یک مدل نرمالشده در محدوده 3NF و رابطههای مشخص با Mapped، mapped_column و relationship() نقطه شروع خوبیه. اگر با PyMongo کار میکنیم، بهتره بسته به الگوی استفاده، ترکیبی از Embedding و Referencing داشته باشیم.
پس سؤال اصلی فقط این نیست که «چند تا جدول یا Collection لازم داریم؟». باید ببینیم این داده به چی وابستهست، چطور تغییر میکنه و معمولاً چطور خونده میشه؟ جواب همین سه سؤال بخش بزرگی از طراحی درست دیتابیس رو مشخص میکنه.
منابع بیشتر
- SQLAlchemy 2.x — Relationship Configuration
- SQLAlchemy — Declarative Mapping
- MongoDB — Data Modeling Best Practices
- MongoDB — Embedded Data
سؤالات متداول
آیا همیشه باید دیتابیس رو تا 5NF نرمالسازی کنیم؟
نه. در خیلی از پروژهها 3NF یا BCNF کافی و قابلنگهداریتره. باید براساس وابستگیهای واقعی داده تصمیم بگیریم.
تفاوت Mapped و mapped_column در SQLAlchemy چیه؟
Mapped نوع ویژگی ORM رو مشخص میکنه و mapped_column تنظیمات ستون رو تعریف میکنه. برای ارتباط بین آبجکتهای مرتبط از relationship استفاده میکنیم.
آیا MongoDB هم 3NF داره؟
قواعد نرمالسازی رابطهای رو میشه برای تحلیل وابستگیها به کار برد، اما مدلسازی MongoDB عمدتاً روی Embedding، Referencing و الگوی دسترسی به داده تمرکز داره؛ پس قرار نیست حتماً همون ساختار جدولهای SQL رو تکرار کنیم.