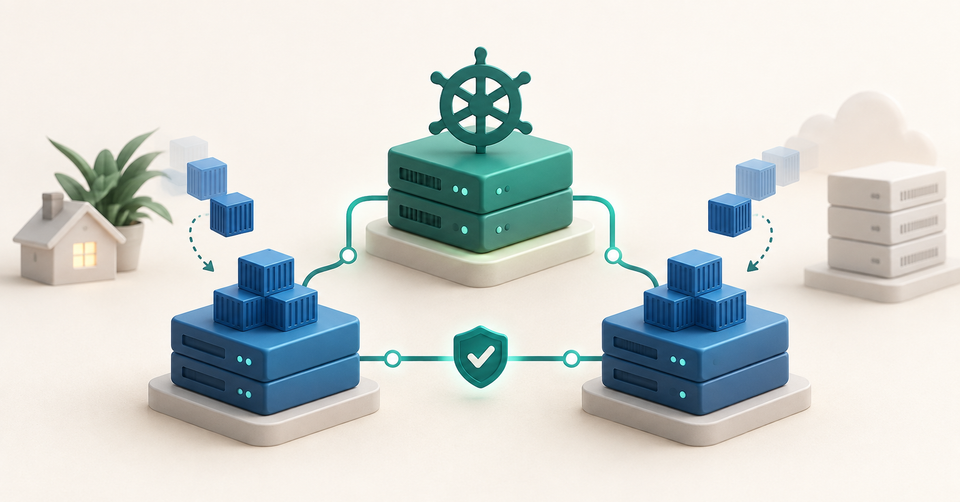
مدتی بود میخواستم Docker Swarm را نه فقط در حد چند دستور پراکنده، بلکه در یک سناریوی نزدیک به محیط واقعی یاد بگیرم. برای همین روی VMware سه سرور Ubuntu ساختم و تصمیم گرفتم تمام مراحل راهاندازی Docker Swarm، اجرای سرویس، Scale، Failover، Rolling Update و مدیریت سرویسها را روی همین Homelab آزمایش کنم.
قبلاً در مطلب راهاندازی ایمیلسرور با Stalwart و Docker از Docker برای اجرای یک سرویس مستقل استفاده کرده بودم. این بار هدفم این بود که یک مرحله جلوتر بروم و چند Docker Engine را به یک کلاستر تبدیل کنم.
سناریوی من شامل این سه سرور است:
| Hostname | IP | نقش اولیه |
|---|---|---|
swarm-manager | 192.168.79.132 | Manager |
swarm-worker-1 | 192.168.79.133 | Worker |
swarm-worker-2 | 192.168.79.134 | Worker |
در این راهنما میخواهم موارد زیر را آزمایش کنم:
- ساخت کلاستر Docker Swarm
- اضافه کردن Workerها
- ساخت Overlay Network
- اجرای یک سرویس Replicated
- تست Routing Mesh
- افزایش و کاهش Replicaها
- Stop، Start، Restart و Remove کردن سرویسها
- خارج کردن یک Node از مدار
- تست Self-healing و Failover
- Rolling Update و Rollback
- Deploy کردن Stack
- بررسی محدودیتهای HA و سرویسهای Stateful
Docker Swarm چیست و چرا سراغش رفتم؟
Docker Swarm ابزار Orchestration داخلی Docker است. با Swarm میتوانم چند سرور Docker را به یک کلاستر تبدیل کنم و سرویسها را بهجای اجرای مستقیم روی یک سرور، در سطح کلاستر مدیریت کنم.
برای این Homelab انتخاب مناسبی بود چون:
- راهاندازی سادهتری نسبت به Kubernetes دارد.
- از همان Docker CLI استفاده میکند.
- برای یادگیری مفاهیمی مثل Service، Replica، Rolling Update و Overlay Network مناسب است.
- برای پروژههای کوچک و متوسط پیچیدگی زیادی ایجاد نمیکند.
- Routing Mesh و Service Discovery داخلی دارد.
البته Swarm قرار نیست در تمام سناریوها جای Kubernetes را بگیرد. هدف من این بود که ابتدا مفاهیم Orchestration و High Availability را در یک محیط کوچک و قابلکنترل یاد بگیرم.
آمادهسازی شبکه و Hostnameها
IP سرورها باید ثابت باشند؛ مخصوصاً IP سرورهای Manager. اگر IP یک Manager بعد از Restart تغییر کند، ارتباط اعضای کلاستر میتواند دچار مشکل شود.
روی هر سرور Hostname مناسب تنظیم کردم:
روی سرور 192.168.79.132:
sudo hostnamectl set-hostname swarm-manager
روی سرور 192.168.79.133:
sudo hostnamectl set-hostname swarm-worker-1
روی سرور 192.168.79.134:
sudo hostnamectl set-hostname swarm-worker-2
سپس روی هر سه سرور این رکوردها را به /etc/hosts اضافه کردم:
192.168.79.132 swarm-manager
192.168.79.133 swarm-worker-1
192.168.79.134 swarm-worker-2
قبل از ساخت Swarm باید ارتباط شبکه را بررسی کرد:
ping -c 3 192.168.79.132
ping -c 3 192.168.79.133
ping -c 3 192.168.79.134
و وضعیت Docker را روی هر سه سرور دید:
sudo systemctl is-active docker
sudo docker version
پورتهای موردنیاز Docker Swarm
برای اینکه Nodeهای Swarm بتوانند با یکدیگر ارتباط برقرار کنند، این پورتها باید بین سرورها باز باشند:
| پورت | پروتکل | کاربرد |
|---|---|---|
2377 | TCP | ارتباط مدیریتی Swarm |
7946 | TCP/UDP | ارتباط و Discovery بین Nodeها |
4789 | UDP | ترافیک Overlay Network |
8080 | TCP | سرویس آزمایشی این مقاله |
اگر UFW فعال است، روی Manager پورت مدیریت را باز میکنم:
sudo ufw allow from 192.168.79.0/24 to any port 2377 proto tcp
روی هر سه Node:
sudo ufw allow from 192.168.79.0/24 to any port 7946 proto tcp
sudo ufw allow from 192.168.79.0/24 to any port 7946 proto udp
sudo ufw allow from 192.168.79.0/24 to any port 4789 proto udp
sudo ufw allow 8080/tcp
پورت 4789/udp نباید بدون دلیل روی اینترنت عمومی باز شود.
ساخت Manager و راهاندازی Docker Swarm
روی سرور 192.168.79.132 کلاستر را ایجاد میکنم:
sudo docker swarm init \
  --advertise-addr 192.168.79.132 \
  --default-addr-pool 10.20.0.0/16 \
  --default-addr-pool-mask-length 24
استفاده از Address Pool اختصاصی اختیاری است، اما کمک میکند شبکههای Overlay با LAN، VMware، VPN یا شبکههای دیگر Docker تداخل نداشته باشند.
خروجی دستور یک Join Token برای Workerها نشان میدهد. اگر بعداً به آن نیاز داشته باشم، میتوانم دوباره آن را بگیرم:
sudo docker swarm join-token worker
Join Token یک Secret محسوب میشود و نباید داخل Git، مقاله یا لاگ عمومی قرار بگیرد.
اضافه کردن Workerها به کلاستر
دستور نمایشدادهشده توسط Manager را روی هر دو Worker اجرا میکنم:
sudo docker swarm join \
  --token SWMTKN-1-REPLACE_WITH_REAL_TOKEN \
  192.168.79.132:2377
سپس روی Manager وضعیت Nodeها را بررسی میکنم:
sudo docker node ls
باید هر سه Node را در وضعیت Ready ببینم:
swarm-manager    Ready    Active    Leader
swarm-worker-1   Ready    Active
swarm-worker-2   Ready    Active
دستورات مدیریتی مثل docker node ls و docker service create باید روی Manager اجرا شوند.
ساخت Overlay Network
برای ارتباط داخلی سرویسها یک Overlay Network میسازم:
sudo docker network create \
  --driver overlay \
  --attachable \
  app-network
و آن را بررسی میکنم:
sudo docker network inspect app-network
Overlay Network اجازه میدهد Containerهایی که روی Nodeهای مختلف اجرا شدهاند، از طریق شبکه مجازی مشترک با یکدیگر ارتباط داشته باشند.
اجرای اولین سرویس روی Docker Swarm
برای آزمایش یک سرویس ساده Whoami با سه Replica ایجاد میکنم:
sudo docker service create \
  --name whoami \
  --network app-network \
  --replicas 3 \
  --publish published=8080,target=80,mode=ingress \
  --update-parallelism 1 \
  --update-delay 5s \
  --restart-condition any \
  traefik/whoami:v1.10.3
وضعیت سرویس:
sudo docker service ls
محل اجرای Taskها:
sudo docker service ps whoami
جزئیات کامل سرویس:
sudo docker service inspect --pretty whoami
Swarm تلاش میکند Taskها را بین Nodeها توزیع کند، اما وجود سه Replica الزاماً به معنی قرار گرفتن دقیقاً یک Replica روی هر Node نیست. تصمیم نهایی بر اساس وضعیت Nodeها، منابع و Placement Constraintها گرفته میشود.
تست Routing Mesh
بهدلیل استفاده از mode=ingress، پورت 8080 روی Routing Mesh منتشر شده است. بنابراین میتوانم از طریق IP هرکدام از Nodeها به سرویس دسترسی داشته باشم؛ حتی اگر روی همان Node هیچ Taskای از سرویس اجرا نشده باشد.
curl http://192.168.79.132:8080
curl http://192.168.79.133:8080
curl http://192.168.79.134:8080
از ویندوز نیز میتوانم اجرا کنم:
curl.exe http://192.168.79.132:8080
curl.exe http://192.168.79.133:8080
curl.exe http://192.168.79.134:8080
برای مشاهده Load Balancing چند درخواست پشت سر هم میفرستم:
1..10 | ForEach-Object {
    curl.exe -s http://192.168.79.132:8080 |
        Select-String "Hostname"
    Start-Sleep -Seconds 1
}
با تغییر مقدار Hostname میتوان دید که درخواستها به Taskهای مختلف هدایت میشوند.
عیبیابی عدم دسترسی از ویندوز
اگر مرورگر یا curl نتوانست به پورت 8080 متصل شود، ابتدا از PowerShell بررسی میکنم:
Test-NetConnection 192.168.79.132 -Port 8080
Test-NetConnection 192.168.79.133 -Port 8080
Test-NetConnection 192.168.79.134 -Port 8080
روی Manager نیز موارد زیر را بررسی میکنم:
sudo docker node ls
sudo docker service ls
sudo docker service ps whoami --no-trunc
sudo docker service inspect whoami --pretty
sudo ufw status verbose
در VMware باید Network Adapter مربوط به VMها روی VMnet صحیح باشد و گزینههای Connected و Connect at power on فعال باشند.
اگر VPN روشن باشد، ممکن است Route شبکه 192.168.79.0/24 را تغییر دهد. در این حالت بهجای حذف کامل Network Adapter، ابتدا VPN را Disconnect میکنم و Routeها را میبینم:
Get-NetRoute -DestinationPrefix 192.168.79.0/24
برای SSH نیز اول خود پورت را تست میکنم:
Test-NetConnection 192.168.79.132 -Port 22
و سپس:
ssh amir@192.168.79.132
افزایش و کاهش تعداد Replicaها
برای افزایش Replicaها:
sudo docker service scale whoami=6
برای کاهش آنها:
sudo docker service scale whoami=2
سپس نتیجه را میبینم:
sudo docker service ps whoami
این همان Declarative State است: من وضعیت مطلوب را مشخص میکنم و Swarm تلاش میکند وضعیت واقعی را با آن هماهنگ کند.
Stop و Start کردن سرویس
Docker Swarm دستور مستقیمی با نام docker service stop ندارد. برای متوقف کردن سرویس بدون حذف Definition آن، تعداد Replicaها را صفر میکنم:
sudo docker service scale whoami=0
برای اجرای مجدد:
sudo docker service scale whoami=3
این روش برای Maintenance موقت مناسب است، چون تنظیمات سرویس حذف نمیشوند.
Restart کردن سرویس
برای Restart کردن تمام Taskهای یک سرویس:
sudo docker service update --force whoami
برای اینکه Restart بهصورت تدریجی انجام شود:
sudo docker service update \
  --force \
  --update-parallelism 1 \
  --update-delay 5s \
  whoami
این دستور Taskها را مرحلهبهمرحله جایگزین میکند و از Restart همزمان تمام Replicaها جلوگیری میکند.
حذف کامل سرویس
برای حذف Definition سرویس و تمام Taskهای آن:
sudo docker service rm whoami
تفاوت این دستور با scale=0 مهم است:
scale=0سرویس را نگه میدارد و فقط Taskهای درحال اجرا را متوقف میکند.service rmسرویس را بهطور کامل از Swarm حذف میکند.
تست Self-healing
ابتدا Taskها را پیدا میکنم:
sudo docker service ps whoami
روی Node میزبان یکی از Containerها:
sudo docker ps
sudo docker kill CONTAINER_ID
بعد از چند ثانیه:
sudo docker service ps whoami
Swarm متوجه میشود یکی از Taskها از بین رفته و Task جدیدی ایجاد میکند. این رفتار یکی از مهمترین تفاوتهای Service با Container مستقل است.
تست Failover یک Worker
برای شبیهسازی خرابی Worker، روی یکی از Workerها Docker را متوقف میکنم:
sudo systemctl stop docker
روی Manager وضعیت را بررسی میکنم:
sudo docker node ls
sudo docker service ps whoami
اگر ظرفیت کافی وجود داشته باشد، Swarm Taskهای از دسترفته را روی Nodeهای سالم دوباره ایجاد میکند.
برای برگرداندن Worker:
sudo systemctl start docker
باید توجه داشت که Failover سرویس با Failover داده متفاوت است. Swarm میتواند Container را دوباره اجرا کند، اما Docker Volume محلی را بهصورت خودکار روی Node دیگر Replicate نمیکند.
خارج کردن امن Node از مدار
قبل از Maintenance بهتر است Node را Drain کنم:
sudo docker node update \
  --availability drain \
  swarm-worker-1
Swarm Taskهای آن Node را به Nodeهای دیگر منتقل میکند.
بعد از پایان Maintenance:
sudo docker node update \
  --availability active \
  swarm-worker-1
این روش از خاموش کردن ناگهانی Node تمیزتر است.
Rolling Update و Rollback
برای انتشار نسخه جدید یک Image:
sudo docker service update \
  --image registry.example.com/myapp:v2 \
  --update-order start-first \
  --update-parallelism 1 \
  --update-delay 10s \
  --update-failure-action rollback \
  whoami
وضعیت Update:
sudo docker service ps whoami
sudo docker service inspect --pretty whoami
اگر نسخه جدید مشکل داشته باشد:
sudo docker service rollback whoami
در محیط واقعی بهتر است Imageها با Tag ثابت یا Digest منتشر شوند و از latest استفاده نشود.
Deploy کردن سرویس با Docker Stack
مدیریت سرویسها با فایل YAML برای من قابلتکرارتر از مجموعهای از دستورات طولانی است.
فایل stack.yml:
services:
  whoami:
    image: traefik/whoami:v1.10.3
    networks:
      - frontend
    ports:
      - target: 80
        published: 8080
        protocol: tcp
        mode: ingress
    deploy:
      replicas: 3
      restart_policy:
        condition: any
        delay: 5s
      update_config:
        parallelism: 1
        delay: 5s
        order: start-first
        failure_action: rollback
      rollback_config:
        parallelism: 1
        delay: 5s
        order: stop-first

networks:
  frontend:
    driver: overlay
Deploy کردن Stack:
sudo docker stack deploy \
  --compose-file stack.yml \
  lab
بررسی Stack:
sudo docker stack ls
sudo docker stack services lab
sudo docker stack ps lab
نام واقعی سرویس بهشکل lab_whoami خواهد بود.
Stop کردن سرویس Stack
sudo docker service scale lab_whoami=0
Start کردن مجدد
sudo docker service scale lab_whoami=3
Restart کردن
sudo docker service update --force lab_whoami
حذف Stack
sudo docker stack rm lab
حذف Stack الزاماً دادههای Volumeهای محلی یا خارجی را حذف نمیکند؛ مدیریت و Backup داده باید جداگانه انجام شود.
استفاده از Secret بهجای Password داخل YAML
قرار دادن Password داخل Compose File یا Environment Variable عمومی روش مناسبی نیست. Swarm برای این کار Secret دارد:
printf '%s' 'change-this-password' |
  sudo docker secret create db_password -
بررسی Secretها:
sudo docker secret ls
سپس میتوان Secret را در Stack تعریف و داخل Container از مسیر /run/secrets/db_password خواند.
آیا یک Manager واقعاً HA است؟
خیر. معماری اولیه من شامل یک Manager و دو Worker است. در این حالت Replicaهای درحال اجرا ممکن است بعد از خرابی Manager همچنان کار کنند، اما Control Plane در دسترس نخواهد بود و Swarm نمیتواند Task جدید ایجاد، جابهجا یا Update کند.
برای HA واقعی Managerها به حداقل سه Manager نیاز دارم. سه Manager میتوانند خرابی یک Manager را تحمل کنند.
در همین Homelab میتوانم دو Worker را Promote کنم:
sudo docker node promote \
  swarm-worker-1 \
  swarm-worker-2
بعد از آن:
sudo docker node ls
هر سه Node به Manager تبدیل میشوند. Managerهای Swarm بهصورت پیشفرض میتوانند Workload هم اجرا کنند، مگر اینکه Availability آنها را تغییر بدهم.
قاعده کلی این است:
| تعداد Manager | Quorum | تحمل خرابی |
|---|---|---|
| 1 | 1 | 0 |
| 3 | 2 | 1 |
| 5 | 3 | 2 |
تعداد فرد Managerها انتخاب مناسبتری است. دو Manager مزیت تحمل خرابی ایجاد نمیکنند، چون برای Quorum همچنان به هر دو نیاز است.
قرار دادن Caddy جلوی Swarm
Routing Mesh باعث میشود یک Published Port از طریق تمام Nodeها قابلدسترسی باشد. بنابراین Caddy میتواند درخواستها را به هر سه Node بفرستد:
swarm.example.local {
    reverse_proxy \
        192.168.79.132:8080 \
        192.168.79.133:8080 \
        192.168.79.134:8080 {
        lb_policy round_robin
        health_uri /
        health_interval 10s
    }
}
اگر Caddy فقط روی یک سرور اجرا شود، خود Caddy به Single Point of Failure تبدیل میشود. برای HA کامل ورودی باید حداقل دو Reverse Proxy، یک Load Balancer یا یک Virtual IP در نظر گرفت.
محدودیت سرویسهای Stateful
Swarm برای سرویسهای Stateless مثل API، Frontend و Workerهای پردازشی سادهتر است. اما سرویسهایی مثل Elasticsearch، Redis، PostgreSQL، Prometheus و Nexus فقط با زیاد کردن Replicaها HA نمیشوند.
برای سرویس Stateful باید موارد زیر جداگانه طراحی شوند:
- Replication در سطح خود نرمافزار
- Storage مشترک یا Distributed Storage
- Backup و Restore
- Placement Constraint
- Health Check
- Quorum
- سیاست Disaster Recovery
Swarm Container را مدیریت میکند، اما بهصورت خودکار داده یک Local Volume را بین Nodeها کپی نمیکند.
پاکسازی کامل محیط آزمایش
ابتدا سرویس یا Stack را حذف میکنم:
sudo docker service rm whoami
یا:
sudo docker stack rm lab
سپس روی Workerها:
sudo docker swarm leave
در پایان، فقط اگر قصد نابود کردن کامل کلاستر را دارم، روی آخرین Manager اجرا میکنم:
sudo docker swarm leave --force
استفاده از --force روی Manager یک عملیات مخرب است و نباید برای عیبیابی معمولی استفاده شود.
جمعبندی
هدف من از ساخت این Homelab فقط بالا آوردن سه VM نبود. میخواستم ببینم وقتی یک Container از بین میرود، یک Worker خاموش میشود یا نسخه جدید Application مشکل دارد، Orchestrator دقیقاً چه واکنشی نشان میدهد.
در این سناریو توانستم موارد زیر را عملاً آزمایش کنم:
- ساخت یک Docker Swarm سهنودی
- اجرای سرویس روی Overlay Network
- دسترسی از طریق Routing Mesh
- Scale کردن Replicaها
- Stop، Start، Restart و Remove کردن سرویسها
- Self-healing و Failover
- Drain کردن Node
- Rolling Update و Rollback
- مدیریت سرویسها با Docker Stack
- تفاوت Service Availability با Manager HA
- محدودیت سرویسهای Stateful
برای یک Homelab یا پروژه کوچک، Docker Swarm نقطه خوبی بین Docker Compose و Kubernetes است: آنقدر ساده است که بتوانم تمام اجزایش را بفهمم و آنقدر قابلیت دارد که مفاهیم واقعی Orchestration را تجربه کنم.
سوالات متداول درباره Docker Swarm
Docker Swarm چیست؟
Docker Swarm ابزار Orchestration داخلی Docker برای مدیریت چند Docker Engine بهعنوان یک کلاستر است. سرویسها میتوانند چند Replica داشته باشند و Swarm وضعیت مطلوب آنها را حفظ میکند.
آیا یک Manager برای High Availability کافی است؟
خیر. یک Manager برای یادگیری و محیط آزمایش مناسب است، اما خرابی آن Control Plane را از دسترس خارج میکند. برای تحمل خرابی یک Manager باید سه Manager داشته باشیم.
چطور یک Docker Swarm Service را Stop کنیم؟
با صفر کردن تعداد Replicaها:
sudo docker service scale SERVICE_NAME=0
چطور سرویس را دوباره Start کنیم؟
تعداد Replicaها را به مقدار موردنظر برمیگردانیم:
sudo docker service scale SERVICE_NAME=3
چطور یک سرویس را Restart کنیم؟
sudo docker service update --force SERVICE_NAME
تفاوت Scale صفر و حذف سرویس چیست؟
scale=0 تنظیمات سرویس را نگه میدارد، اما docker service rm سرویس و Taskهای آن را بهطور کامل از Swarm حذف میکند.
آیا Docker Swarm داده Volumeها را Replicate میکند؟
خیر. Local Volume فقط روی همان Node قرار دارد. برای HA داده باید از Storage مشترک، Distributed Storage یا Replication داخلی نرمافزار استفاده شود.
آیا Docker Swarm هنوز برای پروژههای کوچک مناسب است؟
اگر تیم به Orchestration ساده، Rolling Update، Service Discovery و مدیریت چند Node نیاز داشته باشد و پیچیدگی Kubernetes توجیه نداشته باشد، Swarm همچنان میتواند انتخاب قابلقبولی باشد.